🎥 Résumé analytique
🎯 Promesse cognitive
- À la fin, on comprend : comment OpenFox est structuré, ce que le balayage de fréquence GPU révèle pour l’inférence locale, et quel pipeline génératif permet de créer une interface agent animée.
🧩 Carte du contenu
- Agent de code local OpenFox — architecture planner/builder, mémoire persistante, raisonnement en temps réel et construction d’un visualiseur HTML autonome hors ligne.
- Benchmark de fréquence GPU — mesures de préfill, décodage, TTFT et consommation électrique sur un cluster Spark, avec optimum d’efficacité énergétique évoqué autour de 1700 MHz et choix final à 2150 MHz.
- Pipeline média génératif — chaîne Flux, Minimax H3 et vLLM Omni + Qwen TTS 0.6B pour générer des images, les animer et cloner une voix à partir de quelques secondes d’audio.
✅ Ce que la vidéo apporte en plus de la lecture de ce post
- La vidéo peut ajouter une démonstration en direct de l’agent construisant le visualiseur, des séquences montrant le travail d’OpenFox et le making-of du contenu génératif.
- Le matériel fourni ne permet pas d’établir de manière ferme une contribution visuelle déterminante : la valeur ajoutée principale reste potentiellement liée à la démonstration, à la présentation de l’auteur et au contexte du making-of.
- L’original est donc surtout utile si la forme vidéo et les séquences pratiques intéressent davantage que l’analyse écrite.
🕒 Niveau d’engagement recommandé
- visionnage_actif
- L’essentiel technique est résumable dans le post, mais les séquences de démonstration d’OpenFox, du visualiseur et du pipeline génératif peuvent ajouter une valeur pratique.
- Le plan d’attention signale des passages utiles à vérifier dans l’original, notamment la construction du visualiseur et les sorties génératives, sans certitude complète sur leur valeur visuelle.
Passages susceptibles de mériter l’original
- 06:27 — Création du visualiseur HTML : la vidéo peut montrer la construction, mais la transcription ne garantit pas une démonstration visuelle déterminante.
- 08:20 — Recommandation à 1700 MHz : un graphique pourrait clarifier le compromis fréquence/puissance, mais l’analyse ne confirme pas la présence du visuel.
- 11:21 — Making-of Flux et Minimax H3 : peut présenter les sorties génératives, mais la valeur visuelle réelle reste à vérifier.
🧰 Pistes d’exploitation et points de vigilance
- 1 idée à tester : Tester un balayage de fréquence GPU sur un cluster local d’inférence LLM pour identifier le compromis entre débit de décodage quasi constant, consommation électrique totale et vitesse de préfill.
- 1 notion à creuser : Le compromis fréquence/puissance/débit pour le réglage de clusters GPU destinés à l’inférence LLM locale, en distinguant les mesures de capteurs GPU et la consommation mesurée à la prise.
- 1 limite / biais : Les mesures sont auto-rapportées sur un seul cluster Spark, le nom du modèle d’inférence est incertain et le workload de benchmark est explicitement non représentatif des cas d’usage réels.
🔍 Déroulé détaillé et analyse critique
📄 Voir la synthèse détaillée
Déroulé structuré
Segment 1 — OpenFox : agent de développement local avec mode planificateur/constructeur
Statut : information première partie décrivant un outil personnel ; la branche Fry est présentée comme non publiée.
- Selon l’auteur, OpenFox fonctionne uniquement avec des modèles locaux, sans dépendance internet.
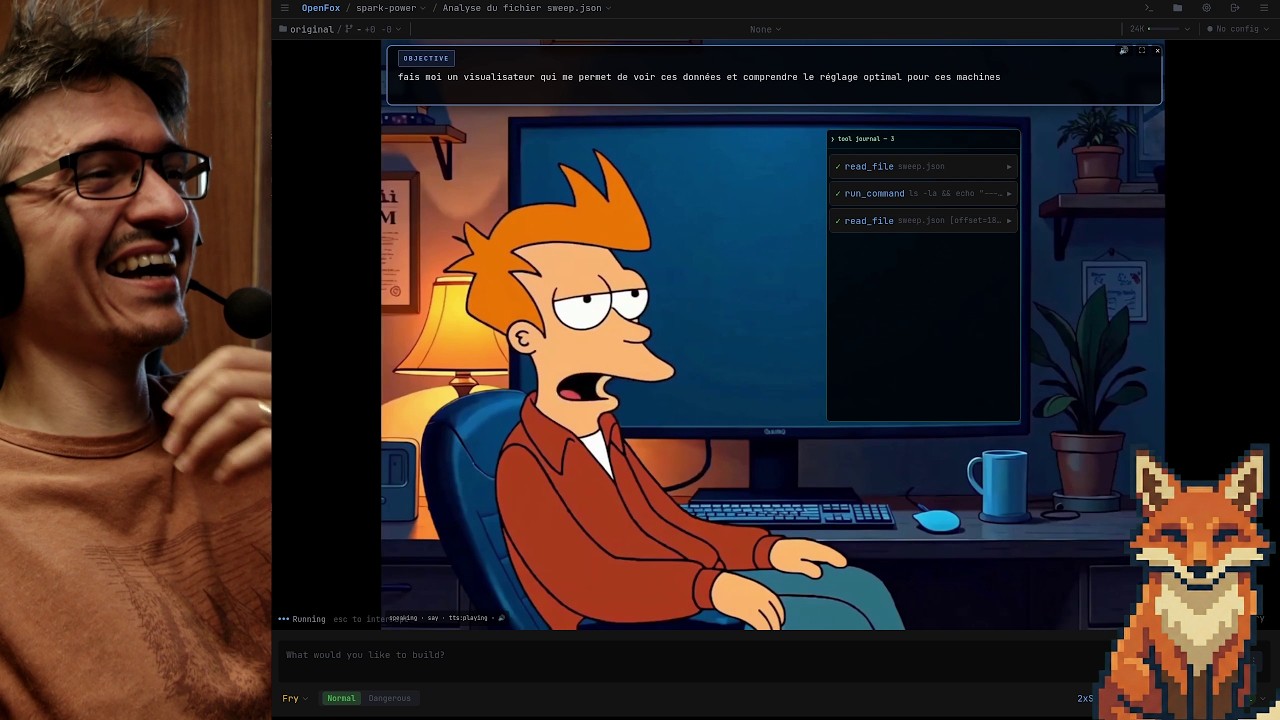
- L’outil est décrit avec deux modes séquentiels : un planificateur qui découpe le travail en étapes, puis un constructeur qui exécute et vérifie le résultat.
- Le raisonnement de l’agent est présenté comme diffusé en temps réel, avec une mémoire persistante stockée dans une base de données.
- L’agent exécute des commandes système : il interroge l’espace disque de Spark 1 et Spark 2, puis lit la consommation GPU via les capteurs.
- Pour le projet benchmark, il construit un visualiseur HTML en page unique, sans bibliothèque externe, chargé directement depuis un fichier JSON.
- L’intégration de Fry de Futurama existe sur une branche à part, présentée comme une blague et non publiée.
Segment 2 — Balayage de fréquence GPU et compromis puissance/débit
Statut : mesures auto-rapportées sur un cluster Spark ; le nom exact du modèle d’inférence est incertain ; le benchmark est présenté par l’auteur comme non représentatif d’un usage réel typique.
- Le balayage couvre 19 points entre 1400 MHz et 2300 MHz, avec 10 répétitions par point, exécuté par un programme de test identifié par la transcription comme Benchi.
- Le modèle utilisé est mentionné dans la transcription comme deic V4 flash, mais ce nom reste incertain.
- Le décodage reste quasi constant, entre 39 et 43 tokens/s, quelle que soit la fréquence.
- La consommation électrique du cluster passe d’environ 230 W à 305 W selon la fréquence ; chaque machine tire environ 120 W pendant le benchmark, avec des températures GPU autour de 60 °C.
- Le visualiseur de l’agent recommande d’abord 1400 MHz, avec un rendement affiché de 0,17 mots/s/W, à cause d’un calcul qui favorise la fréquence la plus basse ; après correction, la recommandation devient 1700 MHz.
- L’auteur choisit finalement 2150 MHz pour se rapprocher du maximum de génération de tokens, en acceptant une perte modérée de vitesse de préfill.
- Les mesures à la prise indiquent environ 253 W pour le cluster complet, tandis que les capteurs GPU indiquent seulement 19 W et 9 W à l’arrêt, ce qui situe la consommation hors GPU sur le processeur et le reste de la machine.
- Les données brutes sont stockées dans un fichier JSON d’environ 8000 lignes, contenant préfill, décodage, TTFT, consommation et température.
Segment 3 — Pipeline génératif pour l’interface Fry animée
Statut : description première partie d’un prototype de divertissement ; limites techniques reconnues par l’auteur.
- Flux, accessible via fal.ai, génère des images statiques du personnage ; un script envoie plusieurs requêtes en parallèle et télécharge les résultats.
- Minimax H3 anime une image fixe en vidéo de 5 secondes, avec des images de départ et de fin facultatives pour définir des transitions.
- Minimax H3 peut être auto-hébergé, mais l’auteur utilise l’API via fal.ai pour la rapidité ; ce chemin est décrit comme environ deux fois plus cher que l’API Minimax directe, qui impose un dépôt minimum de 25 dollars.
- Le serveur vLLM Omni héberge Qwen TTS 0.6B sur Spark 1 ; le clonage vocal fonctionne à partir de quelques secondes d’audio, sans fine-tuning.
- Dans OpenFox, une machine à état transforme l’historique de conversation en séquence d’événements de scène.
- Le TTS ne peut pas fonctionner directement sur le flux de sortie de l’agent : il faut disposer de la phrase complète avant synthèse.
- Les limites reconnues incluent des barres noires sur les bords, l’absence de lip-sync, une seule vidéo bouclée pour la parole et des transitions manquantes.
Points notables
- Le point le plus durable est la relation fréquence/puissance : un décodage quasi plat de 39 à 43 tokens/s face à une consommation qui monte d’environ 230 W à 305 W.
- L’agent détecte lui-même un défaut de calcul dans son visualiseur, ce qui illustre la nécessité de contrôler la logique de métriques d’efficacité énergétique.
- L’écart entre la recommandation de 1700 MHz et le choix de 2150 MHz matérialise le compromis entre efficacité énergétique et débit de génération de tokens.
- La comparaison puissance GPU et puissance à la prise rappelle que la consommation d’un cluster ne se résume pas à la carte graphique.
- La chaîne générative combine trois éléments pratiques : génération d’image Flux, animation image-vers-vidéo Minimax H3 et clonage vocal local via vLLM Omni + Qwen TTS 0.6B.
- L’architecture OpenFox combine agent local, mémoire persistante et sortie HTML autonome, utile comme exemple concret de développement assisté par IA sans cloud.
Limites & biais factuels
- Le format de la vidéo est divertissant, autour de Futurama, et contient des excuses explicites pour l’usage du personnage et du clone vocal.
- Les mesures sont auto-rapportées et non indépendamment vérifiées.
- Le nom du modèle d’inférence utilisé pour le benchmark est incertain à cause de la transcription automatique.
- Le guide technique complet est annoncé comme en cours d’écriture, ce qui peut laisser des informations incomplètes.
- L’auteur précise que le workload de benchmark est intense et ne représente pas un cas réel typique.
- La branche Fry est décrite comme non publiée, ce qui limite la reproductibilité de l’intégration divertissante.
- Certains identifiants techniques issus de la transcription, comme Benchi ou deic V4 flash, restent à confirmer via les liens fournis par l’auteur.