🎥 Résumé analytique
🎯 Promesse cognitive
- À la fin, on comprend : l’essentiel du premier test de DeepSeek V4 Flash : spécifications, tarification, coûts observés, comportements d’auto-verification et limites d’un test unique.
🧩 Carte du contenu
- Spécifications et disponibilité — la mise à jour de DeepSeek V4 Flash est présentée avec sa taille de paramètres et sa disponibilité initiale via l’API, sans poids encore publiés sur Hugging Face.
- Tarification et coûts observés — les prix par million de tokens et les coûts totaux très bas constatés sur les benchmarks du créateur sont détaillés.
- Implémentation d’une fonctionnalité réelle — le modèle implémente une checklist de scores, pose une question de clarification, ajoute des critères d’acceptation et teste lui-même le résultat.
- Benchmarks et auto-verification — la comparaison API / cluster local documente les comportements d’auto-test, la génération d’un mini-jeu Chrome et l’utilisation de Playwright par le réviseur de code.
- Configuration et limites — la configuration OpenFox est décrite, avec les incertitudes sur la vision, la tarification de pointe et la localisation des données.
✅ Ce que la vidéo apporte en plus de la lecture de ce post
La version originale peut ajouter la vision des séquences de code, du mini-jeu Chrome, de l’utilisation de Playwright et de la configuration OpenFox, éléments plus concrets qu’un résumé. Elle n’ajoute pas une évaluation définitive : les coûts, scores et durées restent des observations de premier test.
🕒 Niveau d’engagement recommandé
- visionnage_actif
- Le post peut donner les spécifications, prix et signaux principaux.
- Les séquences de code, du mini-jeu, de Playwright et de la configuration OpenFox apportent une valeur concrète difficile à restituer par écrit.
- Les chiffres restent un premier test unique, donc le visionnage reste utile plutôt qu’une lecture seule.
Passages susceptibles de mériter l’original
- 01:53 — question de clarification et démarrage de l’implémentation réelle de la checklist.
- 10:58 — résultat du premier benchmark, score 5/5 et auto-test effectué par la version API.
- 14:31 — contournement après la boucle de sur-réflexion : écriture du fichier par fragments puis édition.
- 16:20 — le réviseur de code utilise Playwright pour jouer au jeu généré.
- 19:20 — configuration pratique du fournisseur DeepSeek dans OpenFox.
🧰 Pistes d’exploitation et points de vigilance
- 1 idée à tester : répliquer une petite tâche de développement avec DeepSeek V4 Flash via l’API, en activant l’auto-test et le réviseur de code, afin de mesurer coût, temps et fiabilité sur une tâche reproductible.
- 1 notion à creuser : comparer l’économie et la fiabilité des agents de code entre l’API DeepSeek et l’inférence locale, en incluant latence, coût par tâche et qualité de l’auto-verification.
- 1 limite / biais : l’évaluation repose sur un seul créateur, une exécution unique et des éléments promotionnels ; certains détails de modèle et de tarification proviennent de sources secondaires ou d’une transcription bruitée.
🔍 Déroulé détaillé et analyse critique
📄 Voir la synthèse détaillée
Déroulé structuré
Segment 1 — DeepSeek V4 Flash : sortie, test API et benchmarks
Statut : source secondaire, évaluation à exécution unique par un créateur ; certains détails restent rapportés ou incertains.
- Le créateur teste la mise à jour de DeepSeek V4 Flash le jour de sa sortie, présentée comme étant de 284 milliards de paramètres au total et 13 milliards actifs, contre 1,6 trillion pour V4 Pro.
- Au moment de la vidéo, la nouvelle version est accessible principalement via l’API ; les poids ne sont pas encore publiés sur Hugging Face.
- Les prix API rapportés sont 14 cents par million de tokens en entrée, 28 cents en sortie et 0,3 cent en cache ; un doublement des prix en heures de pointe Beijing est mentionné avec une incertitude explicite.
- Le créateur implémente une checklist de scores dans son comparateur de benchmark : le modèle demande où placer un libellé, ajoute des critères d’acceptation, teste via l’API puis charge Playwright pour tester dans un navigateur ; coût indiqué d’environ 3 cents.
- Sur le premier benchmark, la version API obtient 5/5 sur sa checklist, gère l’ambiguïté de la demande, évite un piège de session.db et auto-teste le résultat ; le cluster local produit un résultat fonctionnel mais sans auto-test.
- Sur le second benchmark, la génération d’un mini-jeu Chrome passe d’abord par une boucle de sur-réflexion, puis par un contournement d’écriture par fragments avec espace réservé et édition ; le jeu est jouable, avec un arrière-plan qui défile dans le mauvais sens.
- Pendant la revue de code, le modèle utilise Playwright pour lancer et jouer lui-même au jeu généré, signale de petits défauts, applique une correction et re-teste.
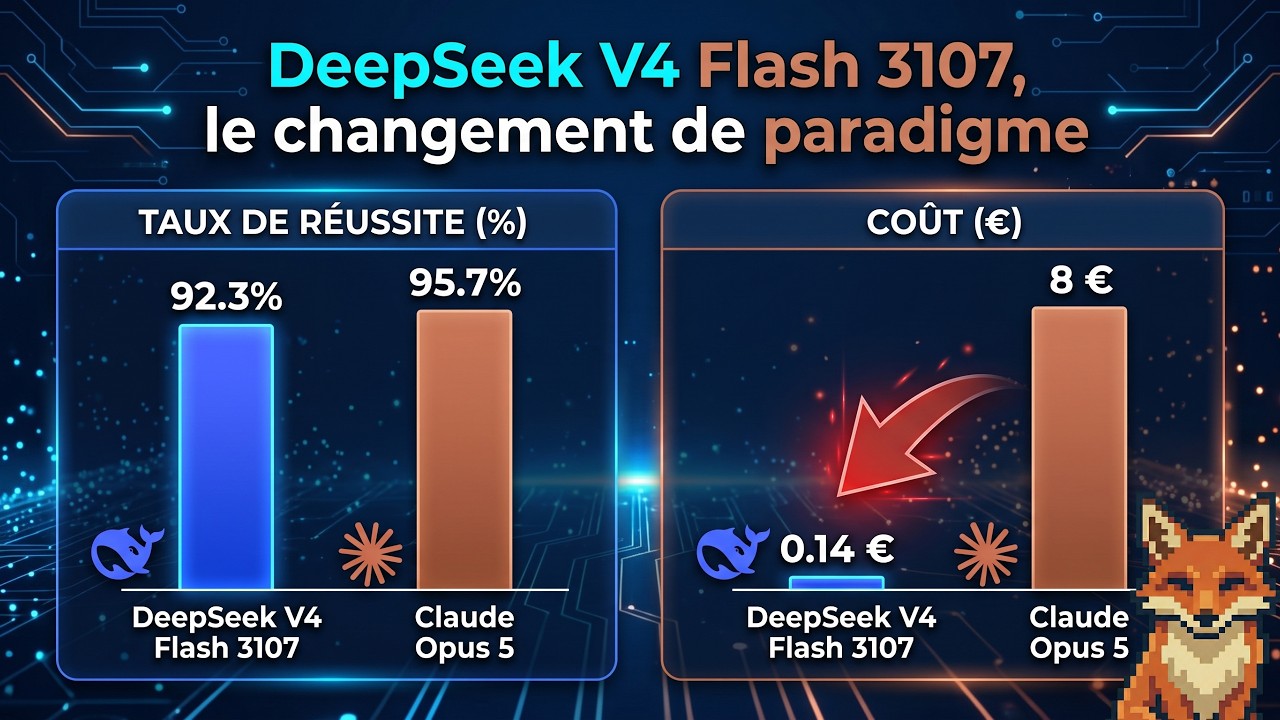
- Le coût total de la suite de benchmarks est indiqué à 14 cents, contre environ 8 à 20 dollars avec d’autres modèles dans l’historique du créateur ; il mesure 125 tokens par seconde et 28 minutes 55 pour le jeu.
- Le créateur juge le ratio qualité/prix exceptionnel, mais s’attend à des cas d’usage problématiques, notamment la sur-réflexion ; il évoque une possible amélioration par post-entraînement, sans confirmation.
- Les points ouverts incluent l’absence probable de vision intégrée, la localisation des données via l’API, la configuration OpenFox avec effort de raisonnement max et température 1, ainsi que le coût matériel local d’environ 8 000 euros.
Points notables
- Le signal le plus utile est économique et comportemental : très faible coût de test, auto-test API, et un réviseur de code qui joue lui-même au résultat via Playwright.
- La comparaison API / cluster local est instructive : la version API ajoute de l’auto-verification, tandis que la version locale reste fonctionnelle mais moins autonome.
- La séquence de génération du jeu montre une fragilité (boucle de raisonnement) et une capacité de reprise (écriture par fragments), utile pour évaluer la robustesse opérationnelle d’un agent de code.
- Le coût matériel local d’environ 8 000 euros rend l’économie API pertinente pour un usage quotidien, même si les mesures ne sont pas des benchmarks normalisés.
Limites & biais factuels
- Les scores, coûts et durées sont des mesures d’exécution unique et non comparables de façon rigoureuse à d’autres benchmarks.
- Le créateur signale explicitement la non-déterminisme des modèles, ce qui rend les résultats sensibles à l’exécution.
- La présence de vision intégrée et la tarification de pointe en heures de Beijing sont incertaines ou non confirmées.
- Le contenu contient des sollicitations promotionnelles, notamment une recommandation de crédits sur la plateforme DeepSeek.
- Certains noms de modèles et détails peuvent être affectés par la transcription automatique ; l’historique de coût s’appuie sur la vidéo précédente du même créateur.